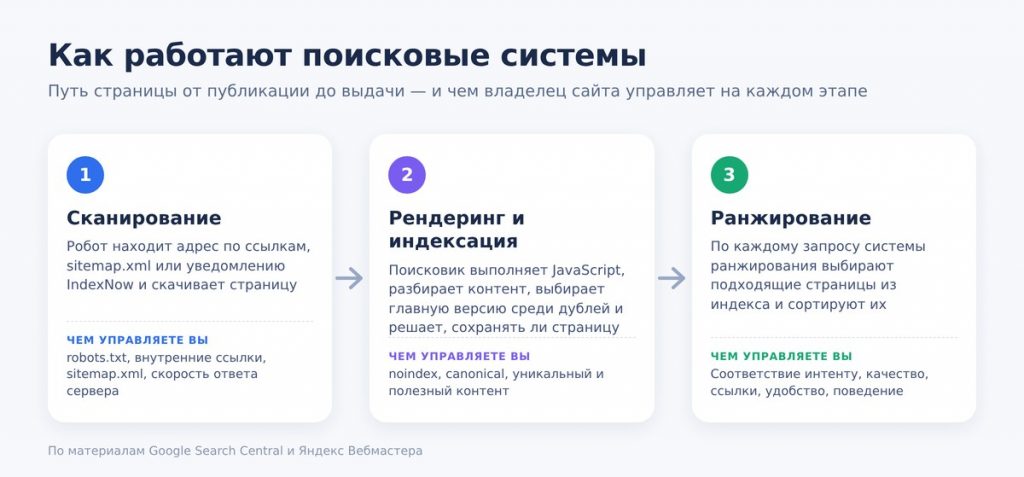
Коротко: поисковая система работает в три этапа. Сначала робот находит и скачивает страницу (сканирование). Затем поисковик разбирает её содержимое и решает, сохранить ли её в базу (индексация). Когда человек вводит запрос, системы ранжирования выбирают из базы подходящие страницы и сортируют их (ранжирование). Страница может «застрять» на любом этапе. Задача SEO — убрать препятствия на каждом из них.
В статье «Что такое SEO и как оно работает» мы разобрали эти этапы в общих чертах. Здесь — подробности, которые пригодятся, когда страницы не появляются в поиске или не поднимаются выше.
Три этапа работы поиска
Google в документации Search Central описывает работу поиска как три этапа: crawling, indexing, serving. Яндекс устроен по той же схеме. Важная оговорка Google: не каждая страница проходит все три этапа. Часть найденных адресов робот не сканирует, часть просканированных не попадает в индекс, часть проиндексированных почти никогда не показывается.
Масштаб задачи огромный. По данным Google, его индекс содержит сотни миллиардов страниц и занимает больше 100 млн гигабайт. Поэтому поисковик постоянно решает, на что тратить ресурсы, и ваша задача — сделать так, чтобы ваши страницы оказались в приоритете.
Сканирование: как робот находит страницы
Сканирование — это обход интернета поисковыми роботами (краулерами). У Google это Googlebot, у Яндекса — YandexBot. Единого каталога всех страниц нет, поэтому роботы узнают о новых адресах тремя путями:
- По ссылкам. Робот переходит по ссылкам с уже известных страниц — и с вашего сайта, и с чужих.
- Из sitemap.xml. Карта сайта сообщает список адресов и даты их обновления.
- По уведомлениям. В Яндекс Вебмастере и Google Search Console можно отправить страницу на переобход. Яндекс и Bing также поддерживают протокол IndexNow: сайт сам сообщает об изменениях, и робот приходит быстрее. Google IndexNow не поддерживает.
Перед обходом робот читает файл robots.txt. В нём можно запретить сканирование разделов, которые не нужны в поиске: корзину, личный кабинет, страницы фильтров с параметрами.
С июля 2024 года Google сканирует все сайты смартфонным роботом. Если на мобильной версии нет части контента, Google его просто не увидит.
Краулинговый бюджет: когда он важен
Краулинговый бюджет — это число страниц, которое робот готов обойти на сайте за определённое время. По документации Google, он складывается из двух частей:
- Лимит нагрузки (crawl capacity). Сколько одновременных подключений и с какой частотой робот может себе позволить, не перегружая сервер. Если сайт отвечает быстро и без ошибок, лимит растёт. Если сервер тормозит или отдаёт ошибки 5xx, робот замедляется.
- Спрос на сканирование (crawl demand). Насколько поисковику интересно обходить сайт: популярность страниц и частота их обновления.
В обновлении документации от июля 2026 года Google уточнил две вещи. Каждый сайт стартует с одинакового консервативного лимита, который затем растёт автоматически. А все краулеры Google, включая робота за картинками, делят один общий лимит. Для неизменённых страниц Google советует отдавать код 304 Not Modified: так робот не тратит ресурсы на повторное скачивание.
Нужно ли об этом думать? По оценке Google, краулинговый бюджет актуален для крупных сайтов: от миллиона страниц с умеренными обновлениями или от 10 тысяч страниц с ежедневными. Небольшому сайту услуг или блогу обычно достаточно не плодить мусорные адреса. Главные «пожиратели» бюджета:
- бесконечные комбинации фильтров и сортировок в каталоге;
- дубли страниц с параметрами (
?utm=,?sort=); - цепочки редиректов;
- битые ссылки и ошибки сервера.
Рендеринг: как поисковик видит JavaScript
Многие сайты собирают содержимое страницы в браузере с помощью JavaScript. Чтобы увидеть такой контент, поисковику нужно выполнить код — это и есть рендеринг. Google рендерит страницы актуальной версией браузера Chromium, но делает это отдельным шагом, иногда с задержкой.
Что из этого следует на практике:
- Важный текст, ссылки и мета-теги надёжнее отдавать сразу в HTML (серверный рендеринг или статическая генерация).
- Ссылки должны быть обычными тегами
<a href>. Переходы по клику через JavaScript без адреса робот может не увидеть. - Не закрывайте в robots.txt файлы скриптов и стилей, без которых страница не собирается.
Проверить, что видит поисковик, можно инструментом проверки URL в Google Search Console и проверкой ответа сервера в Яндекс Вебмастере.
Индексация: что попадает в базу
На этапе индексации поисковик анализирует текст, заголовки, изображения, структурированные данные и решает, сохранять ли страницу. Заодно он ищет дубли: если похожих страниц несколько, поисковик выбирает одну главную (каноническую) и показывает в выдаче только её.
Страница может не попасть в индекс по разным причинам:
- она закрыта тегом
noindex; - она признана дублем другой страницы;
- контента мало или он не несёт ценности;
- поисковик ещё не успел её обработать.
Новички часто путают три инструмента управления индексацией:
| Инструмент | Что делает | Когда использовать |
|---|---|---|
| robots.txt | Запрещает сканирование | Служебные разделы, фильтры, которые не нужны роботу |
| Мета-тег noindex | Запрещает индексацию | Страницы, которые не должны появляться в поиске |
| rel=»canonical» | Указывает главную версию среди похожих страниц | Дубли с параметрами, версии для печати, копии товаров |
Важная тонкость: robots.txt не убирает страницу из индекса. Если на закрытую страницу ведут ссылки, Google может показать её адрес в выдаче без описания. Чтобы страница точно не попала в поиск, её нужно открыть для сканирования и поставить noindex: робот должен прочитать этот тег.
Ранжирование: как выбираются результаты
Ранжирование происходит в момент запроса. Поисковик понимает, что именно ищет человек, выбирает из индекса тысячи подходящих страниц и сортирует их. Учитываются запрос, язык, местоположение, устройство и сотни сигналов о самих страницах.
Google в руководстве по системам ранжирования называет конкретные системы. Их можно разделить на шесть групп.

Подробнее о том, что известно про каждую группу:
- Понимание языка. Нейросети BERT и MUM, а также RankBrain и neural matching сопоставляют запрос и страницу по смыслу. Поэтому страница может ранжироваться по запросу, слов которого в ней нет.
- Ссылки. PageRank — одна из первых систем Google, и она до сих пор входит в ядро ранжирования.
- Качество. Системы полезного и оригинального контента, а также системы надёжной информации повышают материалы, созданные для людей, а не ради трафика.
- Поведение пользователей. В 2024 году в сеть утекли более 2 500 страниц внутренней документации Google (14 014 атрибутов). В них упоминается система Navboost, которая использует данные о кликах, и показатель авторитетности сайта. Веса факторов документы не раскрывают, но подтверждают: реакция пользователей на выдачу учитывается.
Чем отличаются Google и Яндекс
Общая схема у поисковиков одна, а акценты разные.
| Яндекс | ||
|---|---|---|
| Нейросеть для понимания текста | BERT, MUM | YATI (с 2020 года) |
| Ускоренное уведомление о страницах | Нет поддержки IndexNow | Поддерживает IndexNow |
| Поведенческие факторы | Учитываются (Navboost), но официально почти не обсуждаются | Исторически важная группа факторов |
| Региональность | Учитывается | Сильная привязка выдачи к региону |
| Панель для владельца сайта | Google Search Console | Яндекс Вебмастер |
О факторах Яндекса многое стало известно из утечки исходного кода в январе 2023 года. В ней нашли список из 1 922 факторов ранжирования. Среди них PageRank, возраст ссылок, текстовая релевантность, свежесть, надёжность хоста, число уникальных посетителей и доля органического трафика. Код датирован февралём 2022 года, поэтому с тех пор формулы могли измениться. Но общая картина подтвердилась: Яндекс смотрит и на текст, и на ссылки, и на поведение людей.
YATI — это трансформер, похожий на BERT от Google. Его обучали не просто на текстах, а на реальных запросах и документах, которые видели пользователи. Модель предсказывает, какие документы людям понравятся, а какие нет. Отсюда практический вывод: в Яндексе особенно важно, чтобы человек нашёл ответ и не вернулся в выдачу.
Как проверить, что происходит с вашими страницами
Если страница не появляется в поиске, проверяйте этапы по порядку:
- Сканирование. Не закрыта ли страница в robots.txt? Есть ли на неё внутренние ссылки? Есть ли она в sitemap.xml? Отвечает ли сервер кодом 200?
- Рендеринг. Видит ли поисковик основной текст? Проверьте инструментом проверки URL в Search Console.
- Индексация. Нет ли тега noindex? Не указан ли canonical на другую страницу? Не признал ли поисковик страницу дублем? Причины видны в отчётах «Индексирование страниц» в Search Console и «Страницы в поиске» в Вебмастере.
- Ранжирование. Если страница в индексе, но далеко от топа, сравните её с конкурентами: отвечает ли она на интент, достаточно ли полна, есть ли на неё ссылки.
Частые вопросы
Сколько времени нужно, чтобы новая страница попала в индекс? От нескольких часов до нескольких недель. Быстрее всего индексируются страницы на сайтах, которые часто обновляются и на которые много ссылок. Ускорить процесс помогут переобход в панелях вебмастера, sitemap.xml и, для Яндекса, IndexNow.
Индексируется ли всё, что есть на сайте? Нет. Поисковики сознательно не хранят дубли, пустые и малополезные страницы. Это нормально: в индексе должно быть то, что полезно людям.
Можно ли заплатить поисковику за место в выдаче? За органическую выдачу — нет. Платить можно только за рекламные блоки, они помечаются отдельно.
Почему позиции меняются каждый день? Индекс постоянно обновляется, конкуренты меняют страницы, поисковики выкатывают обновления алгоритмов. Плюс выдача зависит от региона, устройства и истории поиска. Колебания в пару позиций — норма.